Cyberatak to nie wszystko
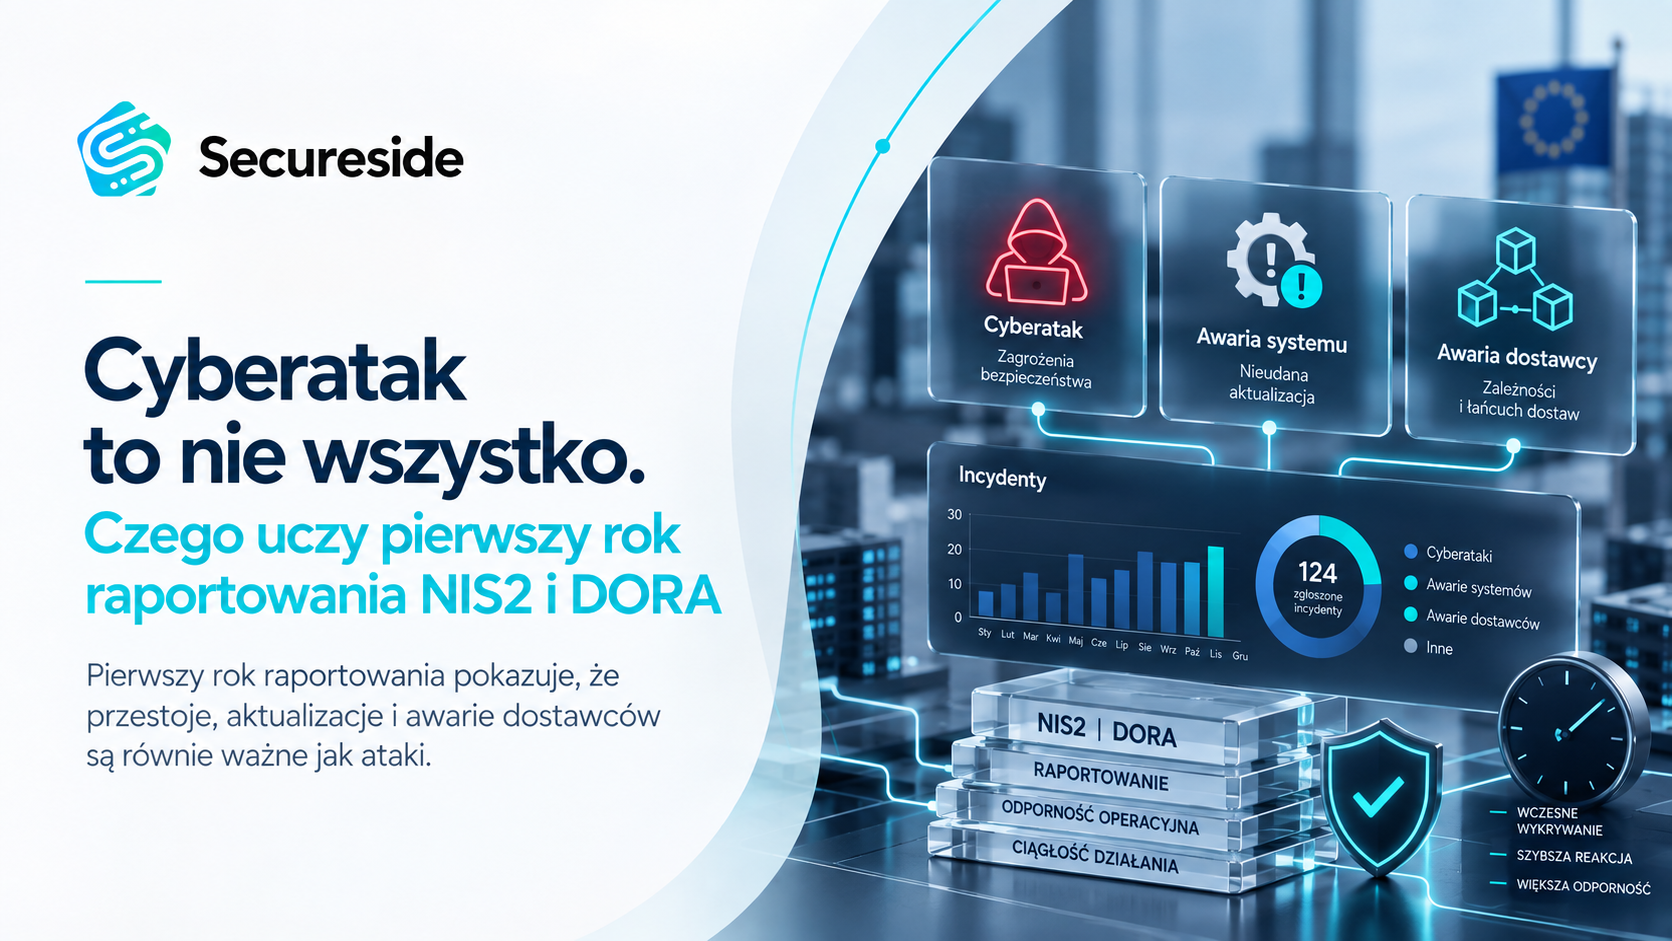
Na posiedzeniach zarządów pytanie brzmi zwykle: czy jesteśmy gotowi na atak? Rzadziej pada drugie: co się stanie, gdy o trzeciej w nocy położy nas własna aktualizacja albo awaria dostawcy. Pierwsze pełne zestawienia incydentów raportowanych na podstawie NIS2 i DORA pokazują, że to drugie pytanie jest dziś co najmniej tak samo ważne.
Liczby
Państwa członkowskie zgłosiły w 2025 r. 1 954 incydenty w ramach obowiązków z art. 23 i 30 NIS2, wobec 1 508 rok wcześniej — przy mniejszej liczbie raportujących państw. To nie dowód pogorszenia bezpieczeństwa, tylko efekt rozszerzania zakresu regulacji i dojrzewania samego raportowania.
Ciekawszy jest rozkład. Po raz pierwszy od pięciu lat najczęstszą kategorią były działania złośliwe, a nie awarie. Ale to awarie kosztowały najwięcej czasu: średnio 48,3 godziny przestoju wobec 8,6 godziny przy zdarzeniach złośliwych. Najbardziej dotkniętym sektorem okazała się administracja publiczna.
Sektor finansowy zgłosił w tym samym roku 3 383 poważne incydenty ICT na podstawie DORA. Awarie systemów odpowiadały za około połowę z nich, zdarzenia zewnętrzne za 27%, incydenty stricte cyberbezpieczeństwa za około 10%. Blisko jedna trzecia miała wpływ transgraniczny.
Zanim ktoś wyciągnie z tego wniosek
Dwie uwagi, bez których te liczby łatwo przeczytać na opak.
Po pierwsze, 3 383 to liczba zgłoszeń, nie liczba awarii. Kiedy pada wspólny dostawca albo infrastruktura grupowa, każdy dotknięty podmiot raportuje osobno – jedno zdarzenie źródłowe potrafi wygenerować kilkadziesiąt zgłoszeń. Bez konsolidacji nie wiemy ani ile naprawdę było zdarzeń, ani które komponenty dają największy efekt mnożnikowy.
Po drugie, niski udział cyberincydentów nie jest dowodem skuteczności zabezpieczeń. Równie dobrze może oznaczać, że czegoś nie wykryto, że skutek ataku zaklasyfikowano jako awarię systemową albo że wpływ nie przekroczył progu istotności. To nie jest czepianie się metodologii. To różnica między zdaniem „mamy dobrą ochronę” a zdaniem „nie wiemy, ile nam umknęło” – a te dwa prowadzą do zupełnie innych decyzji budżetowych.
„Awaria systemu” nie jest przyczyną
Największą słabością tych statystyk jest poziom ogólności przyczyn. „System failure” opisuje moment, w którym coś przestało działać, nie powód. Pod tą etykietą mieści się wada architektury, błąd konfiguracji po zmianie, brak redundancji i nieprzetestowane przełączenie. „Błąd ludzki” z kolei zamyka dochodzenie dokładnie tam, gdzie powinno się zacząć: dlaczego pomyłka jednego operatora nie napotkała żadnej bariery kontrolnej.
Dwa zdarzenia z 2025 r. dobrze to ilustrują. Awaria komponentu pamięci masowej wyłączyła TARGET2 na około 10 godzin mimo istniejącego środowiska zapasowego — rzadkość defektu tłumaczy prawdopodobieństwo jego wystąpienia, nie długość przestoju. A podczas blackoutu na Półwyspie Iberyjskim centra danych banków utrzymały ciągłość na zasilaniu awaryjnym, tylko klient i tak nie mógł zapłacić: padła telekomunikacja, oddziały i terminale.
Wniosek jest prosty i niewygodny. Odporność mierzy się zdolnością klienta do dokończenia procesu, a nie statusem systemów centralnych.
Pięć pytań przed następnym audytem
- Które usługi są u Państwa krytyczne — i czy biznes odpowie na to tak samo jak IT?
- Czy mają ustalone RTO i RPO, które ktoś kiedykolwiek zweryfikował w praktyce?
- Czy znamy zależności od dostawców i mamy plan na ich niedostępność?
- Czy w ostatnich 12 miesiącach testowaliśmy scenariusz awarii, a nie samo odtworzenie kopii?
- Czy w kilka godzin pokażemy regulatorowi, co się stało, jaki był wpływ i co z tym zrobiliśmy?
Jeżeli któraś odpowiedź jest niejasna, to sygnał poważniejszy niż brakująca procedura w dokumentacji.
Co z tego wynika
Dojrzała organizacja nie dąży do zera zgłoszonych incydentów. Zero zwykle świadczy o słabym wykrywaniu, nie o dobrym zabezpieczeniu. Realnym celem jest krótszy czas wykrycia, ograniczony wpływ na klientów, udokumentowana decyzja i wniosek wyciągnięty z każdego zdarzenia — niezależnie od tego, czy źródłem był napastnik, własny proces zmiany, czy dostawca.
Pierwszy rok raportowania potwierdza to, co praktycy wiedzieli wcześniej: największym ryzykiem rzadko jest sam haker. Częściej to własna infrastruktura, zmiana bez kontroli i zależność, której nikt nie sprawdził w warunkach awarii.

Grzegorz Bielecki
vCISO, vCIO i certyfikowany ekspert ds. bezpieczeństwa (CISM, CDPSE, CEH, ISO 27001 Lead Auditor). Od ponad 15 lat wspiera głównie sektor finansowy w budowaniu odporności cyfrowej. Architekt wdrożeń DORA, NIS2\UKSC oraz norm ISO 27001 (SZBI) i ISO 22301 (SZCD). Posiada doświadczenie w projektach zgodności IT przy pozyskiwaniu licencji KIP KNF. Członek ISSA Polska.
Udostępnij ten wpis: